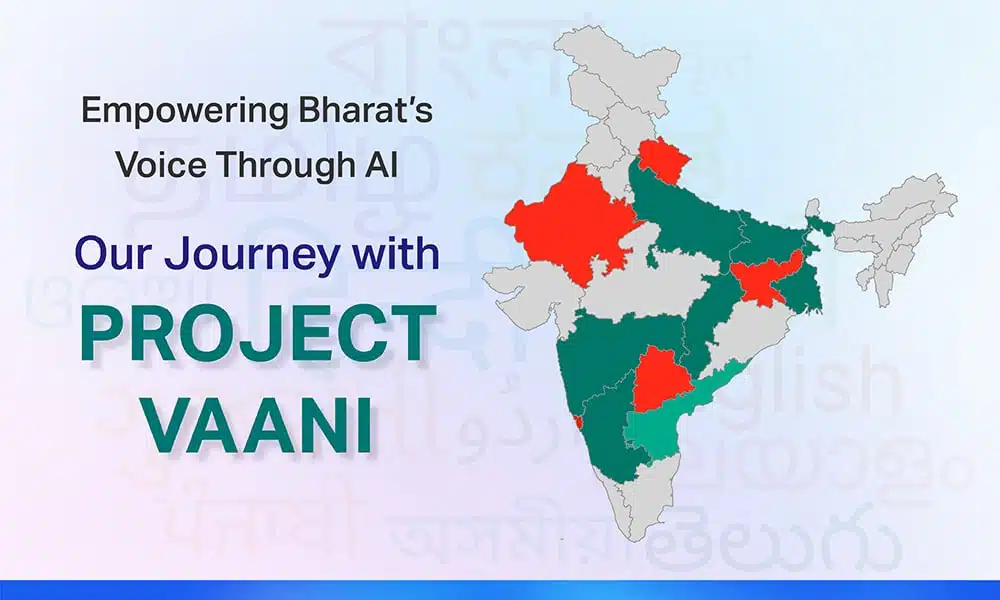
Într-o țară atât de diversă din punct de vedere cultural și bogată din punct de vedere lingvistic precum India, construirea unei inteligențe artificiale incluzive începe cu colectarea de seturi de date reprezentative și de înaltă calitate. Aceasta este viziunea din spatele Proiectului Vaani - o inițiativă open-source la scară largă, condusă de ARTPARK , IISc Bengaluru și Google , care își propune să dea glas fiecărei limbi și dialectelor indiene.
Obiectivul ambițios? Să colecteze peste 150,000 de ore de vorbire și peste 15,000 de ore de transcrieri de la 1 milion de oameni din 773 de districte ale Indiei.
Fiind unul dintre principalii furnizori ai acestei misiuni naționale, Shaip a jucat un rol esențial în colectarea datelor de vorbire spontană, transcriere și metadate – punând bazele unor tehnologii vocale echitabile care reprezintă cu adevărat India reală.
Viziunea din spatele proiectului Vaani
Proiectul Vaani este conceput pentru a reduce decalajul în ceea ce privește incluziunea inteligenței artificiale prin crearea celui mai mare set de date multimodale, multilingve și open-source din India. Aceste date sunt fundamentale pentru dezvoltarea unor sisteme precise de recunoaștere vocală, traducere și inteligență artificială generativă în limbile native indiene - multe dintre acestea fiind subreprezentate în ecosistemele tehnologice globale.
Viziunea pe termen lung este de a alimenta aplicațiile de impact în:
- Farmaceutice – Telemedicina prin voce
- Educaţie – Platforme de învățare vernaculară
- Guvernanță – Interfețe conversaționale pentru serviciile cetățenilor
- Accesibilitate – Instrumente vocale pentru utilizatorii cu capacități diferite
- Răspunsul la dezastre – Comunicare în timp real în dialectele locale
Cum a contribuit Shaip la construirea celui mai mare set de date de vorbire open-source din India pentru Proiectul Vaani
Lui Shaip i-a fost încredințată colectarea a 8,000 de ore de vorbire spontană și 800 de ore de transcrieri verificate manual . Responsabilitățile noastre au cuprins integrarea vorbitorilor, captura audio, etichetarea metadatelor, coordonarea transcrierilor și controlul calității.
8,000 de ore de date audio spontane
Înregistrări de la peste 400 de vorbitori nativi per district, reprezentând diverse grupe de vârstă, sexe și dialecte
80 de districte, acoperite
Îndemnuri bazate pe imagini pentru a asigura o vorbire naturală și contextuală
Iată ce a făcut abordarea noastră unică:
Diversitate la nivel de district
Am obținut înregistrări din 80 de districte răspândite în state precum Bihar, Uttar Pradesh, Karnataka, Bengalul de Vest și Maharashtra. Fiecare district a contribuit cu 100 de ore de date audio, asigurând echilibrul regional. Am implicat vorbitori nativi, asigurând reprezentarea accentelor regionale și a dialectelor adesea trecute cu vederea în seturile de date mainstream AI.
Reprezentare lingvistică și demografică
Am obținut înregistrări din 80 de districte răspândite în state precum Bihar, Uttar Pradesh, Karnataka, Bengalul de Vest și Maharashtra. Fiecare district a contribuit cu 100 de ore de date audio, asigurând echilibrul regional. Am implicat vorbitori nativi, asigurând reprezentarea accentelor regionale și a dialectelor adesea trecute cu vederea în seturile de date mainstream AI.
Vorbire pe bază de imagine
Pentru a stimula vocabularul spontan și natural, participanților li s-au arătat 45-90 de imagini pe sesiune și li sa cerut să le descrie. Participanții au fost îndemnați să utilizeze imagini diverse - de la simboluri culturale la obiecte de zi cu zi - pentru a obține răspunsuri naturale și spontane în limba lor maternă. Acest lucru a asigurat că înregistrările reflectă vorbirea contextuală din lumea reală - esențială pentru antrenarea sistemelor avansate de NLP.
Standarde de transcriere de înaltă calitate
Doar 10% din datele de vorbire au fost transcrise - în valoare de 800 de ore. Trancrierile au fost efectuate de lingviști locali pe o rază de 20–50 km față de vorbitor, asigurând familiaritatea cu dialectele și nuanțele. O verificare al doilea strat a asigurat <5% rata de eroare a cuvintelor (WER).
Asigurare strictă a calității
Datele audio trebuiau să îndeplinească un nivel ridicat: fără zgomot de fundal, ecouri, vibrații ale telefonului sau distorsiuni. Audio a fost înregistrat în medii liniștite, fără ecou. Fișierele au fost supuse unei examinări riguroase pentru a respecta regulile privind claritatea vorbirii, nivelurile de zgomot, acuratețea metadatelor și verificarea difuzorului. Etichetarea metadatelor trebuia să fie precisă în toate fișierele și toate înregistrările au fost verificate pentru alinierea difuzorului și a locației.

Provocări pe care le-am rezolvat
- Logistica de la distanță – Gestionarea echipelor din 80 de districte
- Diversitatea vorbitorilor – Integrarea a peste 32,000 de difuzoare verificate în locații îndepărtate
- Sensibilitate culturală – Respectarea obiceiurilor și dialectelor locale
- Integritatea datelor – Respectarea standardelor de calitate și conformitate
- Controlul calității – în mai multe contexte lingvistice și culturale
Succesul nostru s-a rezumat la planificarea meticuloasă, validarea bazată pe tehnologie și parteneriatele cu echipele locale care au înțeles nuanțele culturale ale fiecărei regiuni.
Impact și aplicații
Contribuția lui Shaip nu numai că a accelerat progresul Proiectului Vaani, ci și a pus bazele pentru IA incluzivă în India. Setul de date de vorbire organizat este deja folosit pentru a construi și a ajusta modele AI pentru:
- Asistenți vocali vernaculari
- Motoare regionale de traducere
- Instrumente de comunicare accesibile pentru persoanele cu deficiențe de vedere
- Platforme edtech bazate pe inteligență artificială pentru studenții din mediul rural
- Telemedicina rurala
- Servicii vocale pentru cetățeni
- Traducere și transcriere în timp real
Concluzie
Proiectul Vaani este un pas îndrăzneț către o inteligență artificială incluzivă și accesibilă - iar Shaip este onorat să joace un rol fundamental. Munca lui Shaip în cadrul Proiectului Vaani reafirmă angajamentul nostru de a construi sisteme de inteligență artificială etice și incluzive, înrădăcinate în diversitate și reprezentare. Cu peste 8,000 de ore de discursuri colectate și 800 de ore transcrise, suntem mândri că am jucat un rol într-unul dintre cele mai vizionare proiecte de incluziune digitală din India.
Pe măsură ce Project Vaani continuă să atingă obiectivul său mai mare de peste 150,000 de ore de date, suntem pregătiți să sprijinim următoarea frontieră a inovației AI care vorbește pentru – și pentru – fiecare indian.
Vrei să colaborezi cu noi pentru a construi o inteligență artificială care înțelege lumea reală? www.shaip.com