Estimarea poziției este sarcina de viziune computerizată de localizare a punctelor cheie ale corpului - articulații și repere faciale - și conectarea lor într-un schelet care descrie modul în care o persoană sau un obiect este poziționat și se mișcă. Pentru inteligența artificială fizică, aceste date despre mișcarea scheletică reprezintă puntea care transformă mișcarea umană observată în acțiuni pe care un robot le poate imita și executa.
Această ultimă propoziție este locul în care atenția industriei s-a îndreptat discret. Timp de un deceniu, estimarea pozițiilor a existat în aplicațiile de fitness și transmisiunile sportive - utilă, dar limitată. Acum, aceleași puncte cheie și schelete au devenit un semnal de antrenament esențial în spatele roboților umanoizi, sistemelor autonome și modelelor de vedere-limbaj-acțiune. Când un robot învață să toarne, să stivuiască, să sorteze sau să dea ceva unei persoane, o mare parte din ceea ce a învățat a provenit din observarea modului în care oamenii au făcut-o inițial - iar această observare reprezintă date despre poziții.
Ce surprinde de fapt estimarea poziției
În esență, estimarea poziției detectează un set de puncte cheie - repere anatomice precum umerii, coatele, încheieturile mâinilor, șoldurile, genunchii și gleznele, plus puncte faciale precum ochii, nasul și urechile - și le leagă într-un schelet care reprezintă postura și mișcarea. Urmăriți acel schelet pe mai multe cadre și veți obține o descriere compactă, lizibilă automat, a modului în care un corp se mișcă în timp.
Domeniul se împarte pe câteva linii familiare. Estimarea poziției umane se concentrează pe oameni; aceleași tehnici se extind la animale și obiecte. Detecția poate fi 2D (localizarea punctelor cheie ca și coordonate de pixeli x, y) sau 3D (adăugarea adâncimii, z, pentru un schelet spațial real). Există și alte opțiuni la nivel de model - de exemplu, detectarea unei singure persoane versus a mai multor persoane - dar acestea sunt decizii de arhitectură pentru echipa de modelare, nu proprietăți ale datelor de antrenament. Ceea ce decide dacă un model de poziție are succes nu este strategia de detectare; ci acuratețea, consecvența și acoperirea punctelor cheie din care a învățat. Aceasta este o problemă de date și este partea pe care echipele o subestimează.
De ce datele despre poziții sunt veriga lipsă pentru inteligența artificială fizică
Un sistem fizic de inteligență artificială trebuie să închidă o buclă pe care un chatbot nu o face niciodată: să perceapă lumea, să decidă și apoi să acționeze în funcție de ea fizic. Percepția s-a maturizat - roboții pot vedea. Partea dificilă este să ancoreze ceea ce văd într-o acțiune coordonată și corectă din punct de vedere fizic, iar datele despre poziție și mișcare sunt cele care o bazează.
Luați în considerare modul în care canalele moderne de învățare a roboților dobândesc abilități. Demonstrațiile reale ale roboților, capturate prin teleoperare, sunt precise, dar lente și costisitoare de colectat. Așadar, echipele se pre-antrenează din ce în ce mai mult pe ceva mult mai abundent: videoclipuri cu oameni care execută sarcini. Cercetările recente în domeniul roboticii au arătat că politicile pre-antrenate pe videoclipuri umane egocentrice la scară largă se pot generaliza mai bine decât cele antrenate doar pe date despre roboți, deoarece videoclipurile umane prezintă diversitatea, fizica și structura sarcinilor pe care datele despre roboți colectate în laborator nu le pot egala la scară largă.
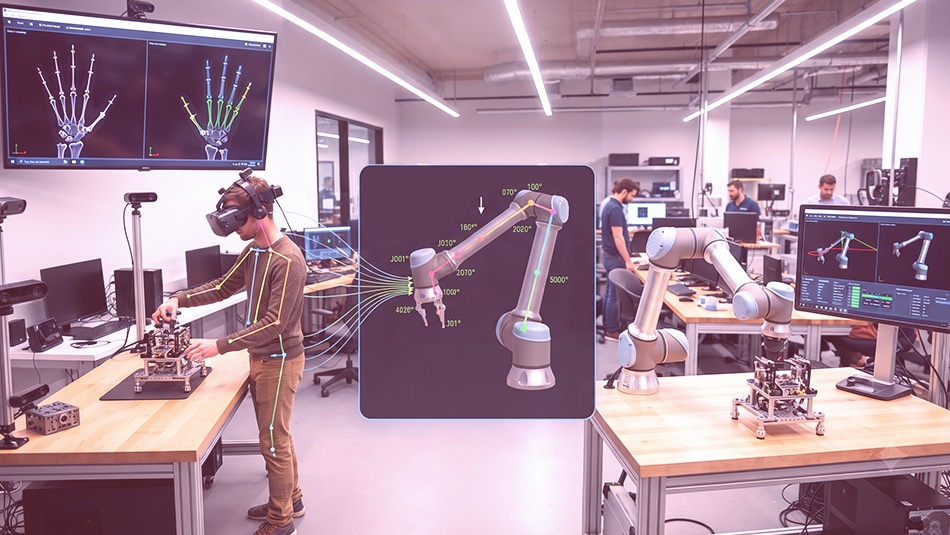
Însă videoclipurile brute cu oameni nu pot fi utilizate direct de către un robot. Un robot nu are un corp identic cu al tău; are propriile articulații, efectori finali și grade de libertate. Estimarea poziției este stratul de translație. Prin reducerea unei demonstrații umane la un schelet structurat - și, în mod esențial, la un schelet de mână - acea mișcare poate fi redirecționată către cinematica unui robot și transformată în traiectorii de acțiune pe baza cărora o politică se poate antrena. Acesta este exact inputul de care sunt însetate modelele viziune-limbaj-acțiune (VLA).
Datele despre poziții apar în stiva fizică-IA în trei forme recurente: poza operatorului surprinsă în timpul teleoperației, poza lucrătorului pentru roboții colaborativi care trebuie să împartă spațiul în siguranță cu oamenii și poza demonstrativă umană, colectată din videoclipuri egocentrice la persoana întâi și redirecționată către acțiunea robotului. În fiecare caz, calitatea scheletului stabilește plafonul calității mișcării pe care robotul o poate învăța.
De la captura de mișcare la mișcarea robotului
Legătura de la mișcarea umană la mișcarea robotului trece adesea prin tehnici de modelare 3D parametrică a corpului care potrivesc un corp complet - și mâini - la puncte cheie estimate, producând o mișcare coerentă din punct de vedere fizic dintr-un videoclip obișnuit. Aceasta este, de fapt, captura de mișcare fără markeri. Pentru robotică, corpul adaptat devine o sursă de traiectorii de acțiune curate: atingere, prindere, ridicare, plasare, eliberare, fiecare fază segmentată și cronometrată. Cu cât adnotarea poziției subiacente este mai bună, cu atât traiectoria redirecționată este mai curată.
Poziție 2D vs. 3D — De care are nevoie robotul tău de fapt
Aceasta este întrebarea pe care echipele de robotică și-o pun cel mai des, iar răspunsul sincer este: depinde ce are robotul de-a face cu poza.
Estimarea poziției 2D vă oferă puncte cheie pe planul imaginii. Este suficientă pentru verificarea formei, recunoașterea gesturilor și clasificarea activității și este mai ieftină de capturat și mai rapidă de adnotat. Dar nu vă poate spune cât de departe este mâna de cană sau unghiul real al unei articulații în spațiu.
Estimarea poziției 3D adaugă axa de adâncime, producând un schelet metric poziționat în trei dimensiuni. Pentru manipulare - prindere, plasare, sarcini bogate în contact - acest lucru este de obicei non-negociabil, deoarece punctele de prindere și unghiurile articulațiilor necesită precizie metrică în momentul în care un robot trebuie să atingă ceva. Poza tridimensională este de obicei recuperată cu camere stereo sau de adâncime, LiDAR, platforme multi-cameră sau ridicare 2D-3D și costă mai mult atât în capturare, cât și în adnotare.
Regula pe care o oferim clienților: dacă sistemul dumneavoastră trebuie doar să înțeleagă mișcarea, 2D-ul poate fi suficient; dacă trebuie să reproducă mișcarea în lumea fizică, planificați pentru 3D - și proiectați stiva de senzori și schema de adnotare în jurul acestui aspect încă din prima zi, nu după prima înțelegere eșuată.
Poziția mâinii și dexteritatea
Dacă poziția corpului duce un robot la obiect, poziția mâinii îi permite să reușească odată ce acesta este acolo. Manipularea dibăcie depinde de urmărirea fină a articulațiilor degetelor, a punctelor de contact și a configurației prizei - adesea douăzeci sau mai multe puncte cheie pe mână. Aici se află în prezent o mare parte din inteligența artificială fizică și unde standardul de adnotare este cel mai ridicat. Datele asociate, video și poziția mâinii, s-au dovedit a fi puternice pentru predarea manipulării; producerea lor fiabilă, la volum mare, este o disciplină specializată.
Unde se întrerup datele de poziție
Modelele de poziții eșuează în moduri previzibile și aproape toate se bazează pe datele de antrenament și nu pe arhitectură:
- Ocluzie. Membrele se ascund în spatele torsurilor, mâinile dispar în spatele obiectelor, subiecții părăsesc cadrul. Fiabilitatea modelului se modifică fie prin semnalarea unor puncte cheie ascunse cu sinceritate, fie prin ghicirea lor.
- Suprapunere între mai multe persoane. Când corpurile se intersectează, punctele cheie sunt schimbate sau îmbinate, așa că urmărirea disciplinată a identității este importantă.
- Punct de vedere, iluminare și variație vestimentară. Un model antrenat doar pe cadre curate, orientate frontal și bine iluminate se prăbușește în lumea reală.
- Ambiguitatea adâncimii. Pentru pozițiile 3D, deducerea adâncimii din vizualizări limitate este în mod inerent dificilă și necesită adnotări consecvente pentru a evita predarea geometriei greșite.
- Mișcare dinamică. Mișcarea rapidă aduce neclaritate și deviație de la un cadru la altul; punctele cheie trebuie să rămână stabile în timp, nu doar corecte în cadre individuale.
- Consistență anatomică. O marcaj la nivelul încheieturii mâinii într-un cadru și la mijlocul antebrațului în următorul otrăvește în liniște setul de date.
Linia de bază: un model de poziție moștenește fiecare inconsecvență din punctele sale cheie, iar în inteligența artificială fizică aceste inconsecvențe devin mișcări greșite - uneori nesigure. Disciplina fluxului de adnotare contează la fel de mult ca volumul brut de date.
În interiorul unui proiect real de poze: proiectul de puncte cheie de 150,000 de cadre al lui Shaip
Pentru un client de viziune computerizată, Shaip a adnotat 150,000 de cadre de imagine și video pe baza unei scheme personalizate cu 36 de puncte cheie - repere faciale plus un schelet complet al corpului - construită pentru a susține atât estimarea poziției, cât și analiza mișcării faciale într-o singură trecere. Lucrarea a cuprins diverse poziții, unghiuri, iluminare și îmbrăcăminte, ocluzia fiind gestionată corect (reperele ascunse semnalizate, niciodată ghicite) și fiecare cadru trecând printr-un control structurat al calității (QA) către un criteriu de referință calibrat. Rezultatul a fost o rețea pregătită pentru producție în spatele modelelor clientului pentru poziție, mișcare, fitness și mișcare din domeniul sănătății. Detalii complete se găsesc în studiul nostru de caz privind adnotarea punctelor cheie ale corpului uman.
Concluzia: proiectul respectiv a antrenat un model de mișcare umană , dar disciplina necesară - o schemă personalizată densă, gestionarea corectă a ocluziilor și diversitatea pozițiilor la scară largă - este aceeași disciplină pe care o cere o politică umanoidă sau de robot colaborativ. Aplicația se schimbă; standardul pentru date nu.
Cazuri de utilizare a estimării pozițiilor: aplicații din lumea reală
Datele despre poziție și mișcare antrenează acum sisteme mult dincolo de robotică, iar fiecare câmp își stabilește propria schemă de puncte cheie și propriul standard de precizie. Pentru echipele de inteligență artificială fizică, observația utilă este că acestea sunt surse suprapuse ale aceluiași element - date de înaltă fidelitate despre mișcarea umană care pot fi redirecționate către inteligența întrupată.
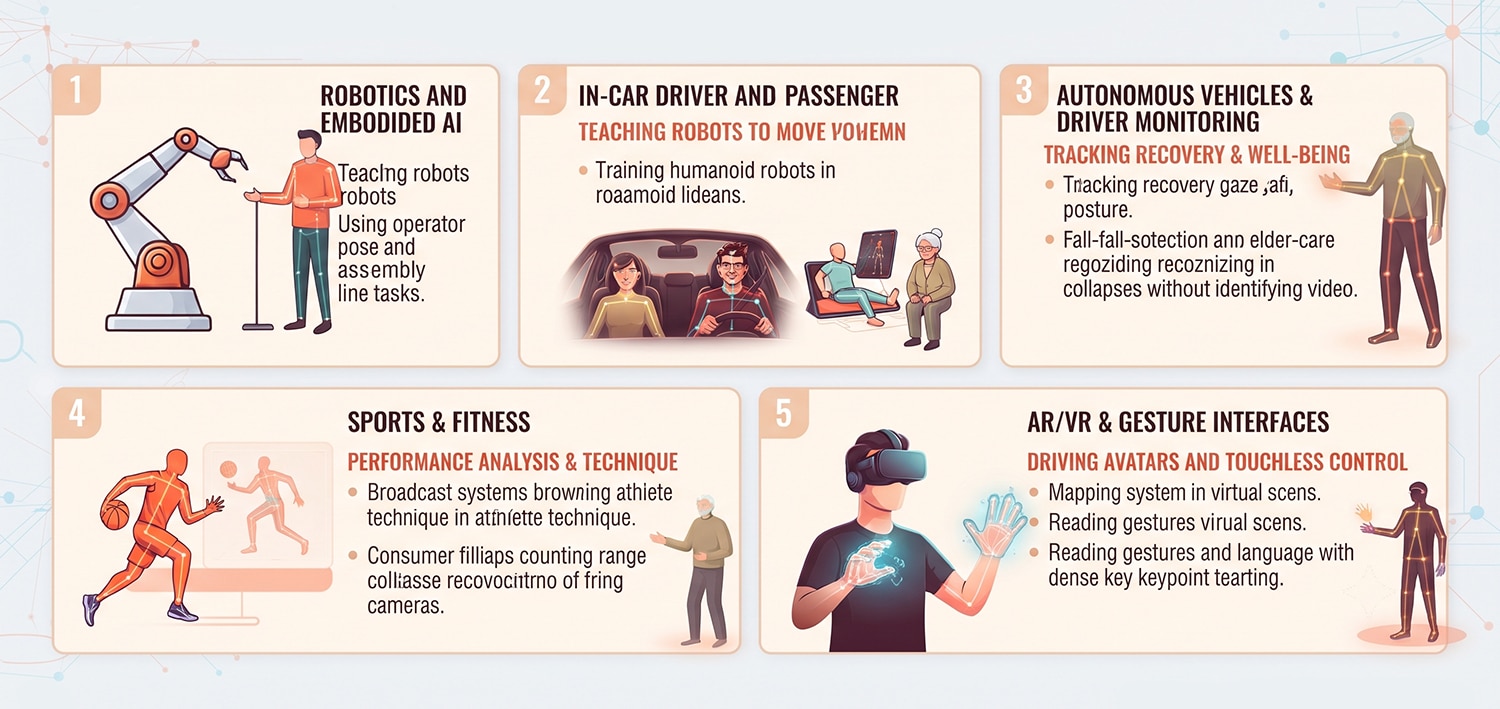
Robotică și inteligența artificială întrupată — frontiera principală. Datele despre poziții îi învață pe roboți să se miște învățând din demonstrațiile umane. Un umanoid dintr-un depozit care învață să ridice containere și să le plaseze pe o bandă transportoare este antrenat parțial pe baza unor înregistrări video cu urmărirea pozițiilor unor persoane care efectuează aceeași sarcină, poziția operatorului din sesiunile de teleoperare furnizând traiectoriile precise ale acțiunii. Pe liniile de asamblare, roboții colaborativi folosesc poziția lucrătorului în timp real pentru a menține o distanță sigură și a preda piese fără coliziuni — genul de sarcini de manipulare a containerelor și de lucru pe linia de producție care sunt acum pilotate în fabricile de logistică și auto.
Vehicule autonome și monitorizarea șoferului. În interiorul cabinei, estimarea poziției urmărește poziția capului, privirea și postura părții superioare a corpului șoferului pentru a detecta somnolența sau distragerea atenției. Sistemele de monitorizare a șoferului livrate în vehiculele noi pentru a îndeplini cerințele de rating de siguranță Euro NCAP 2026 depind exact de aceste date despre reperele faciale și punctele cheie.
Asistență medicală și reabilitare. Estimarea posturilor măsoară modul în care un corp se mișcă efectiv, lucru folosit de medici pentru a urmări recuperarea. O aplicație de fizioterapie poate urmări un pacient care face exerciții fizice prin intermediul camerei unui telefon, poate număra amplitudinea mișcărilor și poate semnala o formă incorectă; un sistem de detectare a căderilor într-un centru de îngrijire a persoanelor în vârstă poate recunoaște o prăbușire doar din mișcarea scheletului, fără a stoca înregistrarea video.
Sport și fitness. Monitorizarea scheletică transformă videoclipurile obișnuite în date despre performanță. Sistemele de transmisie suprapun imagini scheletice în timp real pe atleți pentru a analiza tehnica, în timp ce aplicațiile de fitness pentru consumatori numără repetările și corectează forma folosind doar o cameră de telefon.
Interfețe AR/VR și gesturi. Pozițiile corpului și mâinilor determină avatarele și permit controlul fără atingere. O cască care mapează mâinile într-o scenă virtuală sau o interfață care citește gesturi și limbajul semnelor se bazează pe o urmărire densă a punctelor cheie ale mâinii în condiții de auto-ocluzie puternică.
Alegerea unui partener de date privind pozițiile și punctele cheie
Dacă evaluezi cine ar trebui să construiască datele tale de poziție, întrebările care separă furnizorii sunt operaționale, nu cosmetice: