
În fiecare zi, organizația dumneavoastră produce un munte de cuvinte. Tichete de asistență, contracte, note clinice, recenzii ale clienților, e-mailuri, transcrieri ale apelurilor. Aproximativ 80% din toate datele întreprinderii există sub formă de text nestructurat precum acesta - și până de curând, aproape nimic din ele nu putea fi analizat la scară largă. Pur și simplu stăteau acolo.
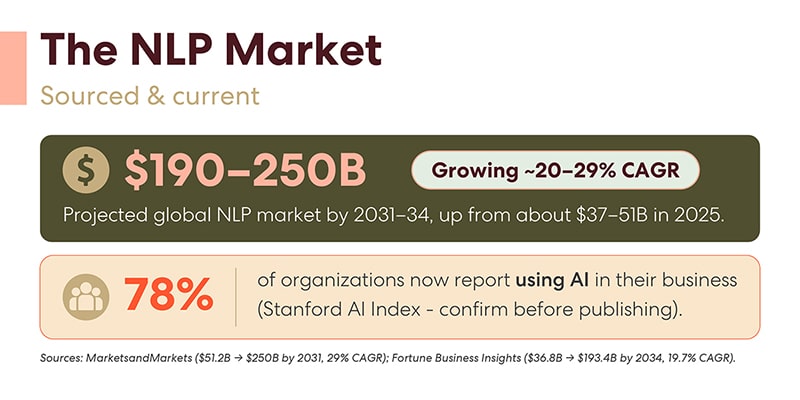
Prelucrarea limbajului natural a schimbat acest lucru. Iar în 2026, când modelele lingvistice mari fac acum munca grea, NLP a trecut de la un domeniu de cercetare de nișă la motorul din spatele aproape fiecărui produs de inteligență artificială pe care îl atingeți. Piața reflectă acest lucru: analiștii prevăd că NLP va crește de la aproximativ 37-51 de miliarde de dolari în 2025 la 190-250 de miliarde de dolari până la începutul anilor 2030, iar 78% dintre organizații raportează deja că utilizează inteligența artificială în afacerile lor.
Deci, ce este mai exact NLP-ul astăzi, cum funcționează de fapt și încotro se îndreaptă? Haideți să analizăm.
Mai întâi, să clarificăm cea mai mare confuzie: NLP vs. LLM
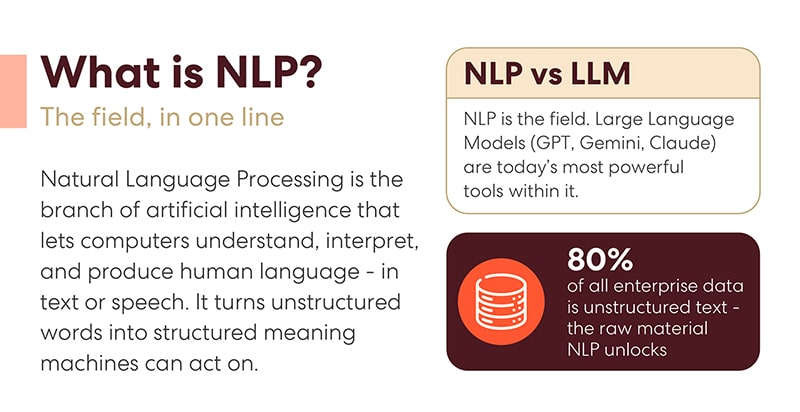
Întreabă zece persoane care este diferența dintre NLP și un LLM și vei primi zece răspunsuri imprecise. Iată versiunea clară: NLP este domeniul - întreaga ramură a inteligenței artificiale care se ocupă de înțelegerea, interpretarea și generarea limbajului uman de către mașini. Modelele de Limbaj Mari precum GPT, Gemini și Claude sunt instrumente din cadrul acestui domeniu. Se întâmplă să fie cele mai puternice instrumente pe care NLP le-a produs vreodată, motiv pentru care cei doi termeni se confundă.
Gândește-te la asta ca la medicină și la aparatele RMN. RMN-ul a transformat medicina, dar nimeni nu spune că medicina este RMN. Aceeași relație. Fiecare LLM este un sistem NLP; NLP este mult mai mare decât orice model singular.
Această distincție contează și în practică. Multe probleme de afaceri - direcționarea unui tichet de asistență, semnalarea unei clauze contractuale, etichetarea sentimentelor în recenzii - nu necesită un LLM de frontieră. Au nevoie de abordarea NLP corectă, care este adesea mai mică, mai ieftină și mai rapidă.
Cum funcționează de fapt NLP-ul modern
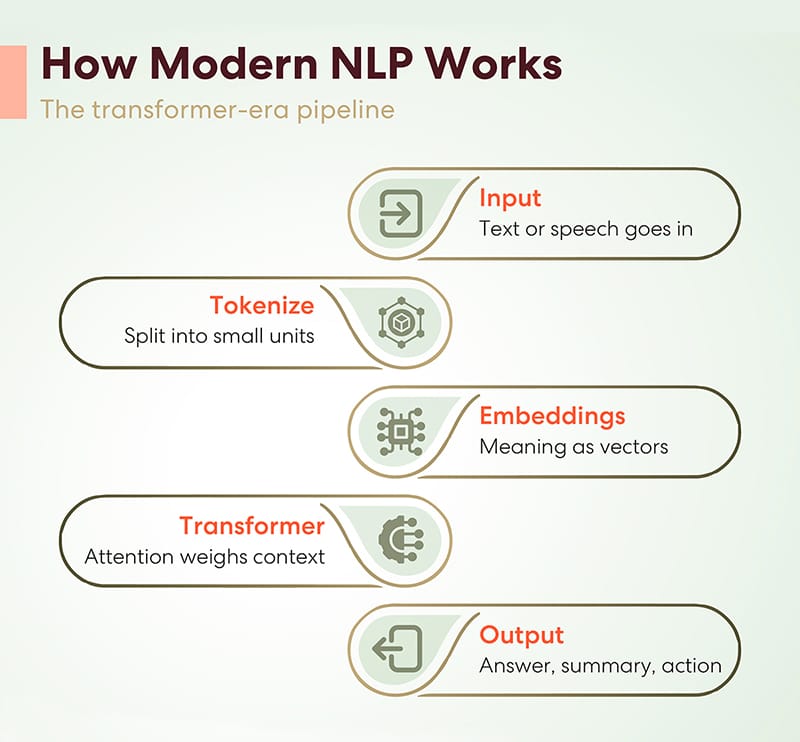
Dacă renunți la exagerări, aproape fiecare sistem NLP modern funcționează pe aceeași pipeline în cinci pași.
Intră text sau vorbire. Sistemul le tokenizează , divizând limbajul în unități mici pe care modelul le poate gestiona. Aceste token-uri devin încorporări - vectori numerici care codifică sensul, astfel încât „medic” și „doctor” ajung aproape unul de celălalt în spațiul matematic. Apoi vine partea care a schimbat totul: transformatorul , al cărui mecanism de atenție cântărește fiecare token în raport cu fiecare alt token pentru a-și da seama ce contează cu adevărat în context. Așa știe un model că în „banca a aprobat împrumutul”, nu vorbim despre un râu. În cele din urmă, modelul produce un rezultat - un răspuns, un rezumat, o traducere, o acțiune.
Asta e tot. Intrare → tokenizare → încorporare → participare → ieșire. Arhitectura transformatorului, introdusă acum mai puțin de un deceniu, se află acum sub aproape fiecare sistem de inteligență artificială lingvistică din producție. Când oamenii vorbesc despre „era LLM”, ei vorbesc de fapt despre era transformatorului la scară largă.
Ce poate face NLP-ul - și cum s-a schimbat fișa postului
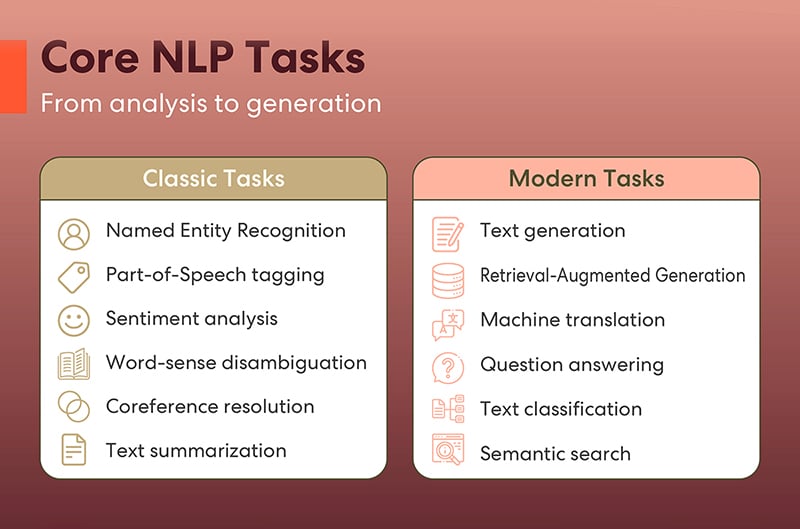
Lista de sarcini a NLP-ului spune povestea evoluției domeniului.
Sarcinile clasice se refereau la analiză : extragerea de nume, companii și date din text (recunoașterea entităților denumite), etichetarea părților de vorbire, detectarea sentimentelor, identificarea sensului unui cuvânt în context (dezambiguizarea sensului cuvântului), identificarea la ce se referă fiecare cuvânt (rezolvarea coreferinței) și condensarea documentelor lungi în rezumate. Acestea sunt încă instrumente esențiale - care alimentează în liniște sistemele de conformitate, motoarele de căutare și canalele de documente de pretutindeni.
Însă era modernă a adăugat generația la acest aspect. Sistemele de astăzi nu doar citesc limbajul, ci îl produc: redactează text, răspund la întrebări, traduc între limbi, clasifică documente la scară largă, alimentează căutarea semantică care se potrivește cu intenția mai degrabă decât cu cuvintele cheie și efectuează generare augmentată prin recuperare - mai multe despre acest aspect mai jos, deoarece își câștigă propria atenție.
Trecerea de la analiză la generație este cea mai mare schimbare din istoria NLP-ului. Mașinile au trecut de la corectarea eseurilor la scrierea lor.
Cele șapte idei care ghidează NLP-ul chiar acum
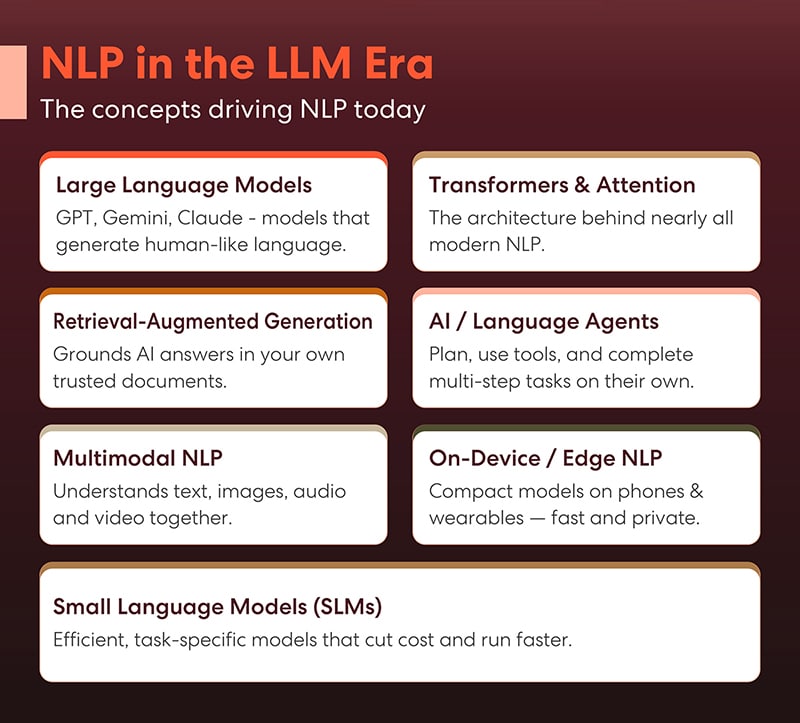
Șapte concepte definesc peisajul actual - iar cunoașterea lor vă va ajuta să analizați orice prezentare a unui furnizor de inteligență artificială în 2026.
Modelele Mari de Limbaj (MLM) sunt în centrul atenției: GPT, Gemini și Claude generează un limbaj asemănător celui uman, cu o fluență care părea imposibilă acum câțiva ani. Acestea sunt motivul pentru care NLP a trecut de la o capacitate administrativă la o conversație în sala de consiliu.
Transformatorii și atenția sunt mecanismul de bază. Aproape fiecare sistem NLP modern - de la LLM-urile de frontieră până la completarea automată de pe telefon - este construit pe această arhitectură, care permite modelelor să evalueze simultan contextul unui întreg document.
Generarea augmentată prin recuperare (RAG) este favorita companiilor dintre cele șapte, deoarece bazează răspunsurile AI pe propriile documente de încredere. În loc să ai încredere în memoria unui model, îl îndrepți către baza ta de cunoștințe verificată - iar halucinațiile scad brusc.
Agenții de inteligență artificială și cei lingvistici preiau modele de la răspunsul la întrebări până la finalizarea lucrărilor: planificarea pașilor, apelarea instrumentelor și executarea sarcinilor cu mai mulți pași cu o supraveghere minimă. Dacă 2024 a fost anul chatbot-urilor, 2026 se conturează ca anul agenților.
NLP-ul multimodal dizolvă granița dintre text și orice altceva. Sistemele moderne procesează textul, imaginile, sunetul și videoclipul împreună — citind un grafic, ascultând un apel și rezumând ambele într-o singură trecere.
NLP-ul on-device/edge lansează modele compacte pe telefoane și dispozitive portabile, unde inferența are loc local. Avantajul este viteza și confidențialitatea: datele tale nu părăsesc niciodată dispozitivul.
Modelele de limbaj mic (SLM) reprezintă contratimpurile ideii „mai mare înseamnă mai bine”: modele eficiente, specifice sarcinilor, care costă o fracțiune din costul unui LLM de frontieră și rulează mai rapid - adesea alegerea mai inteligentă pentru o sarcină bine definită.
Unde NLP-ul își câștigă existența
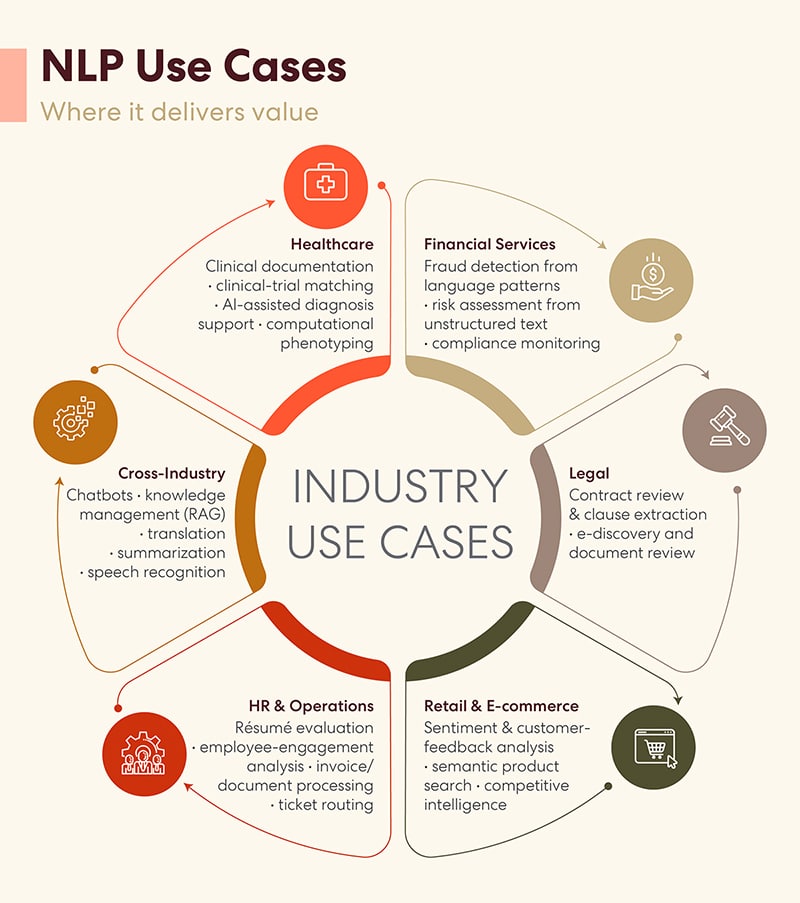
Cazurile de utilizare nu mai sunt speculative - sunt elemente bugetare în toate industriile.
În domeniul sănătății , NLP-ul redactează documentația clinică (oferind medicilor ore înapoi pe săptămână), potrivește pacienții cu studiile clinice și susține diagnosticul prin extragerea de note pe care nicio ființă umană nu le-ar putea citi la scară largă. În serviciile financiare , detectează frauda prin modele lingvistice și monitorizează comunicările pentru conformitate - o sarcină care odinioară necesita armate de recenzori. Echipele juridice îl folosesc pentru revizuirea contractelor, extragerea clauzelor și e-discovery, comprimând săptămâni de revizuire a documentelor în zile. Comercianții cu amănuntul analizează feedback-ul clienților pentru căutare semantică puternică și sentimente care înțelege intenția, nu doar cuvintele cheie. Echipele de resurse umane și operațiuni îl aplică la verificarea CV-urilor, analiza angajamentului, procesarea facturilor și rutarea tichetelor.
Și acoperind fiecare industrie: chatbots, managementul cunoștințelor prin RAG, traducere, sumarizare și recunoaștere vocală. Firul comun este întotdeauna același - textul care anterior era inutilizabil devine date pe baza cărora puteți acționa.
Imaginea sinceră: beneficii și ce merge totuși prost
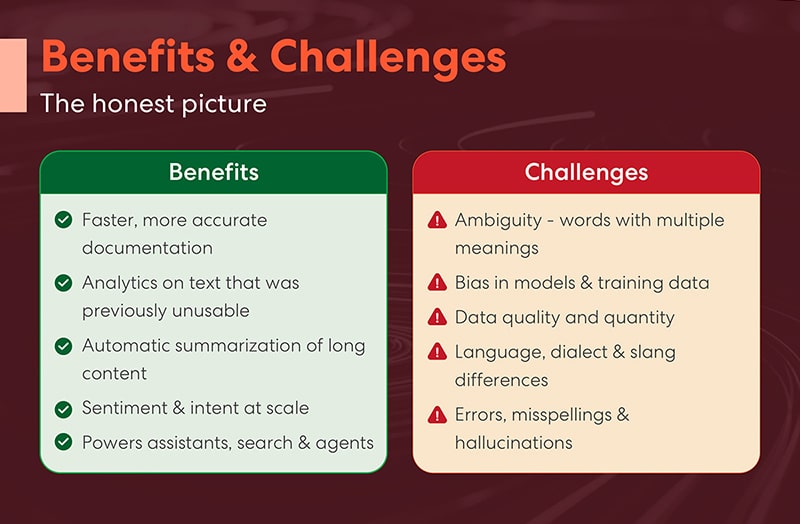
Rezultatul este concret. Documentația este scrisă mai rapid și mai precis. Textul care anterior era inutilizabil devine date analizabile. Conținutul lung se rezumă singur. Sentimentele și intențiile pot fi citite la scară largă pe parcursul a milioane de interacțiuni. Iar întregul stack alimentează asistenții, motoarele de căutare și agenții pe care echipele tale se bazează deja.
Dar ar fi necinstit să încheiem turneul acolo, pentru că NLP-ul în 2026 are încă probleme reale.
Limbajul este ambiguu — cuvintele au înțelesuri multiple, iar modelele încă se împiedică de context pe care orice om l-ar sesiza. Modelele moștenesc erori din datele lor de antrenament, ceea ce poate denatura în liniște instrumentele de angajare, deciziile de creditare și moderarea conținutului. Calitatea datelor rămâne blocajul lipsit de farmec: modelele sunt la fel de bune ca ceea ce învață, iar datele de antrenament de înaltă calitate, bine adnotate, sunt rare și scumpe. Dialectele, argoul și limbile cu resurse reduse au performanțe mai slabe decât engleza standard. Iar halucinațiile — rezultate sigure, fluente și greșite — rămân modul de eșec care menține implementările în întreprinderi prudente.
Niciunul dintre acestea nu este un motiv pentru a sta deoparte. Sunt motive pentru a implementa cu atenție: bazați modelele pe date verificate, evaluați-le în funcție de limbajul dvs. și de utilizatorii dvs. și țineți oamenii la curent cu aspectele legate de erorile care sunt costisitoare. În mod special, majoritatea acestor provocări au ca sursă principală aceeași cauză - modelele de date sunt antrenate și evaluate - motiv pentru care calitatea datelor a devenit un factor de diferențiere competitiv, nu o cheie de bifat.
Ce urmează: Cinci tendințe de urmărit până în 2026
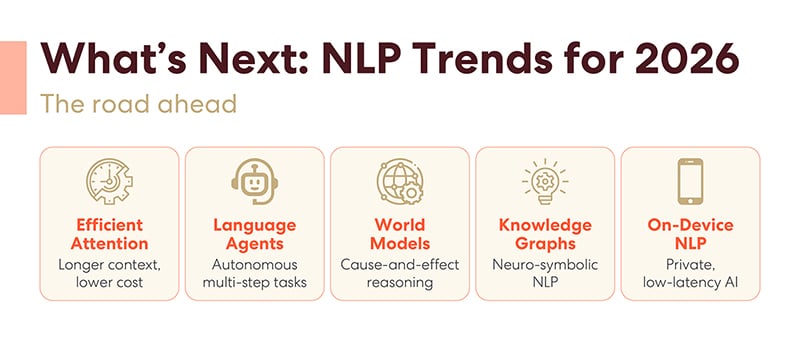
Privind în perspectivă, cinci dezvoltări sunt menite să definească următoarea fază a domeniului. Mecanismele eficiente de atenție extind ferestrele de context, reducând în același timp costurile, permițând modelelor să raționeze simultan pe baze de cod sau fișiere de caz întregi. Agenții lingvistici trec de la demonstrații la producție, gestionând autonom fluxuri de lucru în mai mulți pași. Modelele mondiale își propun să ofere inteligenței artificiale un raționament autentic cauză-efect, mai degrabă decât potrivirea tiparelor. Grafurile de cunoștințe se îmbină cu abordările neuronale - NLP neuro-simbolic - pentru a face rezultatele modelului mai factuale și auditabile. Iar NLP-ul de pe dispozitiv continuă să micșoreze modelele capabile până când inteligența artificială privată, cu latență redusă, încăpea în buzunar.
Modelul general pentru toate cele cinci: mai puțină forță brută, mai multă precizie. Mai ieftin, mai rapid, mai sănătos, mai aproape de utilizator.
Linia de jos
În 2026, NLP nu mai este o tehnologie emergentă - este o infrastructură, la fel de banală și indispensabilă ca bazele de date. Organizațiile care avansează nu sunt cele care se întreabă dacă să utilizeze NLP; sunt cele care se întreabă ce sarcini să automatizeze mai întâi, cum să bazeze modelele pe propriile date și cum să se asigure că datele de antrenament care stau la baza tuturor acestor procese merită învățate.