
Servicii de date de instruire AI pentru învățare automată și IA generativă
Shaip este un furnizor important de date pentru instruire în domeniul inteligenței artificiale, care ajută echipele de inteligență artificială și învățare automată să construiască modele precise, imparțiale și pregătite pentru producție - de la colectarea și adnotarea datelor până la reglarea fină a LLM și evaluarea modelelor, în peste 65 de limbi și peste 60 de țări.
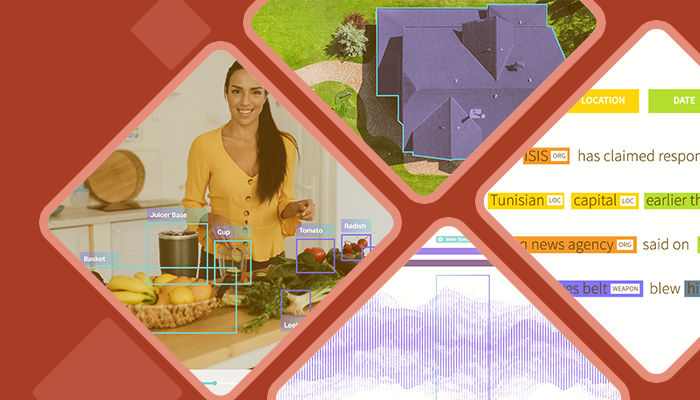
Fundația fiecărui model de inteligență artificială
Ce sunt datele de antrenament bazate pe inteligență artificială?
Datele de antrenament bazate pe inteligență artificială sunt informațiile etichetate sau structurate utilizate pentru a învăța un model de învățare automată cum să recunoască tipare și să facă predicții. Calitatea, diversitatea și acuratețea acestor date determină în mod direct cât de bine performează un model în lumea reală.
Datele de instruire AI de înaltă calitate sunt reprezentative pentru utilizarea în lumea reală, etichetate cu precizie, echilibrate pentru a reduce erorile și conforme cu reglementările privind confidențialitatea datelor. Datele de calitate slabă sunt principala cauză a predicțiilor inexacte, a halucinațiilor modelului și a ciclurilor de recalificare costisitoare - motiv pentru care echipele de AI de top colaborează cu o companie specializată în date de instruire AI, precum Shaip, în loc să se bazeze pe etichetare ad-hoc, internă.
Servicii de date AI end-to-end
Serviciile noastre de date pentru instruire cu inteligență artificială
Tot ce aveți nevoie pe parcursul întregului ciclu de viață al modelului — de la obținerea datelor brute până la reglarea fină și evaluarea modelului.
Servicii de colectare a datelor
Seturi de date personalizate audio, vocale, imagini, video și text — date din lumea reală, cu consimțământ deplin, colectate în peste 60 de țări și în peste 65 de limbi, astfel încât modelul dvs. să învețe din exemple diverse și reprezentative.
Aflați mai multe →Adnotarea și etichetarea datelor
Etichetare perfectă la nivel de pixel de către adnotatori instruiți și experți în domeniu — casete de delimitare, segmentare, NER, etichetare a sentimentelor și intențiilor și transcriere — validată prin QA pe mai multe niveluri.
Aflați mai multe →Date generative despre inteligența artificială și LLM
SFT, RLHF, perechi prompt-răspuns, clasificarea preferințelor umane și seturi de date RAG furnizate de experți în domeniu pentru a îmbunătăți acuratețea, a reduce halucinațiile și a alinia comportamentul modelului.
Aflați mai multe →Validarea și evaluarea datelor
Validare umană, audituri de prejudecată și corectitudine și benchmarking al calității pentru a măsura și îmbunătăți acuratețea modelului înainte și după implementare.
Aflați mai multe →Seturi de date disponibile
Seturi de date pre-etichetate, gata de utilizare, din catalogul nostru de date — peste 30 de milioane de dosare medicale anonimizate, peste 70,000 de ore de vorbire și scenarii cu inteligență artificială fizică.
Explorează catalogul de date →Date fizice despre inteligența artificială și robotică
Adnotare LiDAR și nor de puncte, fuziune de senzori, cutii de delimitare 3D, traiectorii de roboți și scenarii de sarcini din lumea reală care antrenează mașini autonome, roboți și inteligență artificială întruchipată.
Vezi IA fizică și robotică →Fiecare modalitate, un singur partener
Date de antrenament AI după tipul de date
Pentru fiecare modalitate, ne ocupăm de ambele părți ale muncii - obținerea datelor brute pe care nu le puteți găsi direct de pe piață și etichetarea lor conform standardului de care are nevoie modelul dumneavoastră. Un singur partener, un singur proces de asigurare a calității, de la colectare la adnotare și livrare.
Colectarea și adnotarea datelor textuale
Colectăm: Texte și documente specifice domeniului — note clinice, contracte, transcrieri de chat și asistență, precum și seturi de răspunsuri prompte, scrise de specialiști verificați în peste 65 de limbi.
Adnotăm: NER, clasificarea sentimentelor, a intențiilor, legătura entităților și etichetarea documentelor care transformă textul nestructurat în date de antrenament NLP și LLM.
Colectare și adnotare de vorbire și audio
Colectăm: Discursuri spontane, scrise și înregistrate în centre de apeluri, de către vorbitori nativi în peste 65 de limbi, accente, dialecte și medii acustice reale.
Adnotăm: transcriere, jurnalizare și identificare a vorbitorului, marcare temporală, etichetare a emoțiilor și intențiilor pentru ASR, asistenți vocali și inteligență artificială conversațională.
Servicii de colectare și adnotare a imaginilor
Colectăm: seturi de date de imagini personalizate, realizate conform specificațiilor dumneavoastră — fețe și date biometrice, documente și chitanțe, rafturi de magazine, imagistică medicală și cazuri limită în ceea ce privește iluminatul și zonele geografice pe care le va întâlni modelul dumneavoastră.
Adnotăm: Casete de încadrare 2D/3D, poligoane, segmentare semantică perfectă la nivel de pixel, repere și puncte cheie.
Servicii de colectare și adnotare video
Colectăm: Imagini egocentrice, cu mai multe camere, CCTV, camere de bord și din magazin, surprinse de o rețea globală de colaboratori, în scenarii preconcepute și din mediul real.
Adnotăm: urmărirea obiectelor cadru cu cadru, estimarea activității și a poziției și clasificarea evenimentelor pentru robotică, conducere autonomă, sport și video cu inteligență artificială pentru comerțul cu amănuntul.
Inteligență artificială fizică, robotică și date senzoriale
Colectăm: capturi multisenzoriale din medii reale — LiDAR, adâncime, IMU, captură de mișcare VR, teleoperare și traiectorii de roboți în peste 1,400 de scenarii de sarcini și 9 medii.
Adnotăm: Casete de delimitare 3D, segmentare a norilor de puncte, aliniere a fuziunii senzorilor și etichetare a limbajului vizual pentru IA întruchipată.
Generarea și validarea datelor sintetice
Generăm: date sintetice reprezentative de text, imagini și date de senzori acolo unde colectarea din lumea reală este rară, sensibilă sau nesigură pentru a fi pusă în scenă - evenimente rare, cazuri limită cu coadă lungă și domenii cu restricții de confidențialitate.
Validăm: revizuire umană, verificări ale prejudecăților și seturi combinate de ingrediente reale și sintetice, astfel încât calitatea să se mențină în producție.
Expertiza umană pentru inteligența artificială modernă
Date generative de instruire în domeniul inteligenței artificiale și al masteratului în drept (LLM)
Construirea sau ajustarea fină a unui model lingvistic extins necesită mai mult decât text brut. Shaip oferă expertiza umană ce face ca modelele generative să fie precise, sigure și aliniate.
Reglaj fin supravegheat (SFT)
Perechi prompt-răspuns de înaltă calitate, scrise de experți în domeniu.
RLHF și clasamentul preferințelor
Feedback uman și comparații ale răspunsurilor pentru alinierea comportamentului modelului.
RAG și date augmentate prin recuperare
Baze de cunoștințe de domeniu, segmentare a documentelor și perechi interogare-pasaj care bazează răspunsurile modelului în propriul conținut.
Evaluarea modelului
Auditul halucinațiilor, verificări ale factualității și evaluarea calității.
Date de la experți în domeniu
Sugestii, răspunsuri și evaluări redactate de specialiști acreditați în domeniul sănătății, juridic, financiar și nu numai.
Acoperire multilingvă
Adnotatori experți în peste 65 de limbi și domenii specializate.
Date pentru lumea reală
Date de antrenament fizic pentru inteligența artificială și robotică
Roboții, vehiculele autonome și inteligența artificială întrupată învață din lumea fizică - iar acest lucru necesită date 3D precise, de la senzori și de mișcare. Shaip oferă seturi de date multimodale, din lumea reală, pentru peste 1,400 de scenarii de sarcini și 9 medii, pentru a antrena percepția, navigarea și manipularea.
Adnotare LiDAR și nor de puncte
Casete de încadrare 3D, segmentare semantică și urmărire a obiectelor pe nori de puncte.
Fuziunea senzorului
Date aliniate de la cameră, LiDAR, radar și IMU pentru o percepție robustă multi-senzor.
Traiectorii și teleoperare ale roboților
Date demonstrative, acțiuni și manipulări pentru imitație și învățare prin întărire.
Activitatea umană și estimarea poziției
Puncte cheie, gesturi și date de interacțiune pentru o colaborare sigură om-robot.
Detectarea și urmărirea obiectelor
Detectarea, clasificarea și urmărirea mai multor obiecte prin fluxuri de la camere și senzori pentru percepție în timp real.
Scenarii de sarcini din lumea reală
Peste 1,400 de scenarii în 9 medii pentru robotică în depozite, locuințe, industrie și exterior.
De ce să alegeți Shaip ca furnizor de date pentru instruire în domeniul inteligenței artificiale?
Capabilitati de colectare a datelor
Creați, organizați și colectați seturi de date personalizate (text, vorbire, imagine, video) de pe tot globul, pe baza regulilor personalizate.
Forță de muncă globală flexibilă
Valorificați cei peste 10,000 de angajați interni la nivel global și cei peste 500 de contribuitori acreditați la scară largă. Capacitatea și eficiența forței de muncă în timp real.
Calitate
Platforma noastră proprietară și forța de muncă calificată utilizează mai multe metode de control al calității pentru a îndeplini sau depăși standardele de calitate.
Diverse, precise și rapide
Procesul nostru simplifică procesul de colectare prin distribuirea mai ușoară a sarcinilor și capturarea datelor direct din aplicație și web.
Securitatea datelor
Păstrați confidențialitatea completă a datelor făcând confidențialitatea noastră prioritatea. Ne asigurăm că formatele de date sunt controlate și păstrate prin politici.
Ciclu de viață complet
Un singur partener pentru colectare, adnotare, reglare fină a inteligenței artificiale generative și evaluare
Cum funcționează
Cum vă livrăm datele de instruire
Securitate și conformitate


Povestește-ne despre următoarea ta inițiativă în domeniul inteligenței artificiale.
De la colectarea datelor la adnotare, licențiere și validare — vă vom ajuta să ajungeți pe piață mai rapid, cu date în care puteți avea încredere.
Contactează-neÎntrebări Frecvente (FAQ)
1. Ce sunt datele de antrenament ale inteligenței artificiale?
Datele de antrenament AI sunt datele etichetate sau structurate utilizate pentru a învăța un model de învățare automată să recunoască tipare și să facă predicții. Pot fi text, audio, imagini, video sau date multimodale, iar calitatea lor determină în mod direct acuratețea modelului.
2. La ce se folosesc datele de antrenament ale inteligenței artificiale?
Este utilizat pentru antrenarea, reglarea fină și evaluarea modelelor de inteligență artificială și învățare automată - inclusiv sisteme de viziune computerizată, recunoaștere vocală, inteligență artificială conversațională și modele lingvistice mari.
3. Ce tipuri de date de antrenament pentru inteligența artificială oferă Shaip?
Shaip oferă date text, vocale și audio, imagini, video, multimodale, date fizice de tip IA/senzori și date sintetice — prin colectare, adnotare și etichetare, reglare fină LLM și servicii de validare.
4. Cum asigură Shaip calitatea datelor de antrenament?
Fiecare proiect utilizează anotatori experți în domeniu și asigurare a calității pe mai multe niveluri, cu implicare umană, inclusiv revizuire consensuală, eșantionare și verificare a erorilor de evaluare, cu raportare cuantificată a calității.
5. Ce limbi și țări acoperă Shaip?
Shaip acceptă peste 65 de limbi și obține date aprobate din peste 60 de țări, cu o rețea de peste 1,000 de specialiști în date verificați.
6. Sunt datele mele în siguranță și ce certificări deține Shaip?
Da. Shaip este certificată ISO 27001 și ISO 9001:2015, auditată SOC 2 Tip II, conformă cu HIPAA și pregătită pentru GDPR/CCPA, cu mascare PII, criptare și acces bazat pe roluri.
7. Poate Shaip să furnizeze date de antrenament pentru LLM-uri și IA generativă?
Da. Shaip oferă reglaje fine supervizate (SFT), RLHF, clasificare a preferințelor umane, seturi de date RAG, perechi prompt-răspuns și evaluare a modelelor pentru modele lingvistice mari și inteligență artificială generativă.
8. Shaip oferă date de antrenament fizic pentru inteligența artificială și robotică?
Da. Shaip oferă date de antrenament pentru inteligența artificială fizică și robotică, inclusiv adnotări LiDAR și nor de puncte, fuziune de senzori, cutii de delimitare 3D, traiectorii de roboți, date SLAM și de navigare, precum și scenarii de sarcini din lumea reală în peste 1,400 de scenarii și 9 medii pentru sisteme autonome și inteligență artificială întruchipată.
9. Cum se stabilește prețul datelor de antrenament cu inteligență artificială?
Prețurile depind de tipul de date, volum, complexitatea adnotărilor, limbi și termen de execuție. Shaip oferă o ofertă personalizată după ce a analizat cazul de utilizare - solicitați o ofertă gratuită pentru a începe.
10. Oferă Shaip seturi de date standard?
Da. Seturi de date pre-etichetate, gata de utilizare, sunt disponibile în catalogul de date Shaip, inclusiv dosare medicale, vorbire multilingvă și scenarii de inteligență artificială fizică, pentru licențiere.
11. Cum încep să utilizez Shaip?
Contactați Shaip cu cazul dumneavoastră de utilizare pentru a stabili definirea unui proiect pilot. Ne aliniem la liniile directoare și obiectivele de calitate, apoi livrăm o mostră sau un lot pilot înainte de scalare.
