
-
-
-
Antrenează și ajustează fin
-
Evaluare expertă gestionată
-
-
Specialitatea
-
-
Companie
De ceva vreme se deliberează despre modul în care Inteligența Artificială (IA) este menită să schimbe fiecare aspect al vieții umane și, până acum, probabil v-ați dat seama deja că are potențialul de a fi cea mai disruptivă tehnologie din toate timpurile. Astăzi putem vorbi cu Siri, Cortana sau Google pentru a primi răspunsuri la întrebările noastre de bază, dar o mare parte din potențialul lor real este încă necunoscut.
Construirea unei inteligențe artificiale care înțelege cu adevărat limbajul uman necesită mai mult decât date brute - necesită seturi de date de instruire etichetate cu precizie, experte din punct de vedere lingvistic, livrate la scară largă în cadrul întreprinderii. Shaip este un furnizor important de servicii NLP, care oferă servicii și soluții complete de procesare a limbajului natural pentru echipele de inteligență artificială din întreaga lume: de la colectarea personalizată de date text și audio la adnotări de specialitate, seturi de date NLP standard și livrare completă a forței de muncă în peste 150 de limbi.
Indiferent dacă antrenezi un sistem conversațional de inteligență artificială, ajustezi fin un model lingvistic extins (LLM), construiești un motor de analiză a sentimentelor sau scalezi o pipeline de recunoaștere a entităților numite (NER) - cei peste 30 de colaboratori acreditați ai Shaip oferă datele structurate și de înaltă calitate pentru antrenamentul NLP de care modelele tale au nevoie pentru a funcționa cu precizie în lumea reală. Având încrederea companiilor Fortune 500 din domeniul sănătății, finanțelor, tehnologiei și comerțului cu amănuntul, soluțiile NLP ale Shaip combină instrumente de platformă proprie, procese de calitate 6 Sigma și experți în domeniu pentru a satisface cerințele de precizie și randament ale inteligenței artificiale de nivel de producție.

Fiecare model lingvistic de înaltă performanță începe cu date de antrenament specifice domeniului, construite special. Serviciile de colectare a datelor NLP de la Shaip furnizează informațiile precise de care are nevoie modelul dvs. - la volum, în limba dvs. și cu variabilitatea lingvistică pe care o cere implementarea în lumea reală.
Colectăm corpusuri de text personalizate, de volum mare, în diverse formate: e-mailuri, recenzii ale clienților, postări pe rețelele sociale, tichete de asistență, contracte legale, documente financiare și multe altele. Disponibile în peste 150 de limbi și dialecte regionale, serviciile noastre de colectare a textului contribuie la instruirea chatbot-urilor, la reglarea fină a LLM-urilor, la sistemele de relevanță a căutării și la procesele de înțelegere a documentelor.
De la solicitări scriptate la dialoguri conversaționale spontane, Shaip colectează înregistrări audio de înaltă calitate, adaptate cerințelor dvs. ASR sau AI vocală - inclusiv accente specifice, medii cu zgomot, date demografice ale vorbitorilor și condiții ale canalului. Livrate ca colecții independente sau ca pachete ASR complete cu transcriere, lexicon de pronunție și documentație specifică limbii pentru antrenamentul imediat al modelului. Toate datele colectate sunt livrate cu metadate complete, atribuirea vorbitorilor și verificarea calității prin platforma proprie de adnotare Shaip.
Modelele NLP precise necesită date de antrenament adnotate cu precizie. Serviciile de adnotare a datelor oferite de Shaip combină o forță de muncă multilingvă acreditată cu o platformă proprie pentru a oferi etichete precise în mod constant la scară largă - cu porți de calitate încorporate și urmărire transparentă a livrării.

Capacitățile noastre de adnotare NLP acoperă fiecare tip major de sarcină:
Toate adnotările sunt livrate printr-un proces de calitate 6 Sigma stage-gate, cu scorare a acordului inter-anotatori și bucle continue de feedback.

Răsfoiți setul nostru de date audio cu diverse seturi de date NLP standard, care cuprind peste 20,000 de ore de audio, pe o varietate de subiecte, cum ar fi call center, conversații generale, dezbateri, discursuri, prezentări, documentare, evenimente, conversații generale, filme, știri etc., în peste 40 de limbi.
Vă oferim o resursă calificată care devine o extensie a echipei dumneavoastră pentru a vă sprijini sarcinile de adnotare a datelor, prin intermediul instrumentelor pe care le preferați, menținând în același timp calitatea dorită. Forța noastră de muncă experimentată înțelege subtilitățile limbajelor umane și aplică cele mai bune practici învățate prin etichetarea a milioane de documente audio și text pentru a oferi o soluție de etichetare a datelor de clasă mondială pentru procesarea limbajului natural.

De la colectarea de text/audio până la adnotare, oferim o înțelegere mai profundă a lumii vorbite cu text și audio detaliate și etichetate cu precizie pentru a îmbunătăți performanța modelelor NLP. Indiferent dacă instruiți un asistent virtual/digital, doriți să revizuiți un contract legal sau să construiți un algoritm de analiză financiară, vă oferim datele standard de aur de care aveți nevoie pentru ca modelele dvs. să funcționeze în lumea reală. Echipa noastră înțelege limbajul, dialectul, sintaxa și structura propozițiilor pentru a eticheta cu precizie textul, în funcție de cerințele afacerii dvs.
Suntem una dintre puținele companii NLP care se mândrește cu abilitățile sale lingvistice puternice. Avem o forță de muncă globală de peste 30,000 de colaboratori din întreaga lume, cu expertiză în peste 150 de limbi . Am ajutat startup-uri aflate în stadiu incipient, întreprinderi mici și mijlocii și am lucrat cu companii de top din topul Fortune 500 din diferite verticale , cum ar fi sănătate, retail/comerț electronic, finanțe, tehnologie și multe altele, pentru a le atinge obiectivele proiectelor NLP.
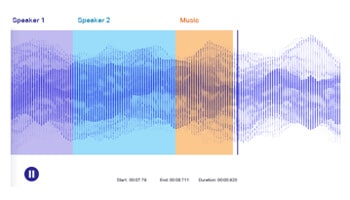
Peste 50 de ore de seturi de date audio/vorbire disponibile pentru a vă pune în practică.
Analizați emoția umană prin interpretarea nuanțelor din recenziile clienților, rețelele sociale etc.

Colectați seturi de date text, adică e-mailuri, SMS-uri, bloguri, documente, lucrări de cercetare etc.

Formarea asistenților digitali necesită un set mare de date de calitate din diferite zone geografice, limbi, dialecte, configurații și formate. La Shaip, oferim date de instruire pentru modelele AI cu Human-in-the-loop care au cunoștințele necesare, expertiza în domeniu și sunt bine conștienți de nevoile specifice ale clientului.
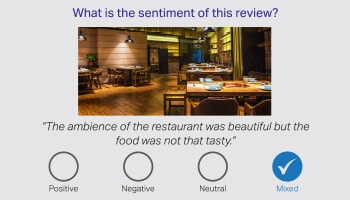
Se spune pe bună dreptate că numai cuvintele nu reușesc să comunice întreaga poveste, iar sarcina revine adnotatorilor umani de a interpreta ambiguitatea în limbajul uman. Prin urmare, identificarea Sentimentului unui client, pe baza conversației, este de cea mai mare importanță. Experții noștri lingvistici din diverse domenii pot interpreta nuanțele din recenziile produselor, știrile financiare și rețelele sociale.
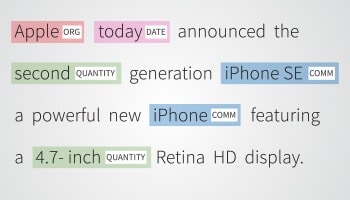
Named Entity Recognition (NER) este identificarea, extragerea și clasificarea entităților numite într-un text, în categorii predefinite. Textul poate fi clasificat ca loc, nume, organizație, produs, cantitate, valoare, procent etc. Cu NER puteți adresa întrebări din lumea reală, cum ar fi ce organizații au fost menționate în articol etc.
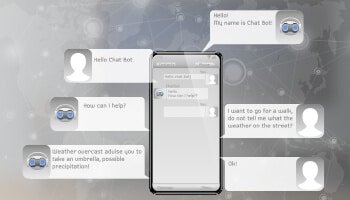
Chatboții virtuali sau asistenții digitali robusti și bine pregătiți au revoluționat modul în care clienții comunică cu vânzătorii, contribuind la îmbunătățirea semnificativă a experienței clienților.
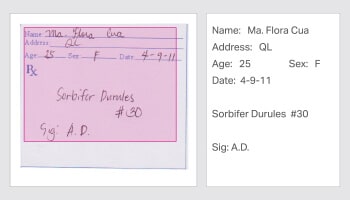
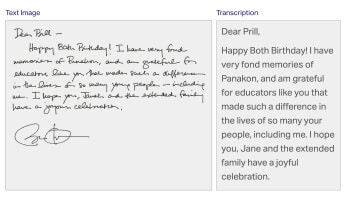
De la rețetele de mână ale medicilor până la notele de teleconferință, specialiștii noștri pot digitiza orice formă de date, cum ar fi documente arhivate, contracte legale, fișe medicale ale pacienților etc.
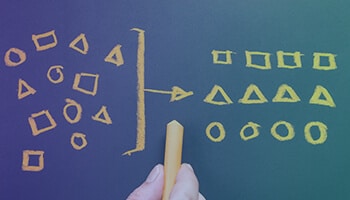
Categorizarea, cunoscută și sub denumirea de clasificare sau etichetare, este procesul de clasificare a textului în grupuri organizate și de etichetare, pe baza caracteristicilor sale de interes.
Evaluarea și post-editarea umană a rezultatelor traducerii automate pentru a măsura fluența, adecvarea și acuratețea domeniului — permițând sisteme de traducere automată fiabile pentru implementări multilingve.
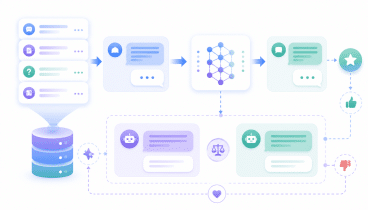
Seturi de date curatoriate privind urmărirea instrucțiunilor, perechi prompt-răspuns și date privind preferințele RLHF pentru a regla fin și alinia modelele lingvistice mari la cerințele domeniului, tonului și sarcinii dumneavoastră.
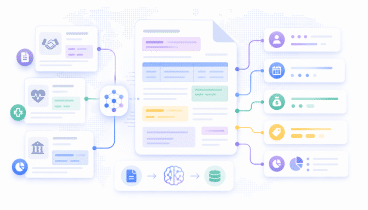
Adnotarea structurilor complexe de documente - contracte, dosare medicale, documente financiare - pentru a antrena modele de inteligență artificială pentru documente care extrag, clasifică și analizează text nestructurat la scară largă.
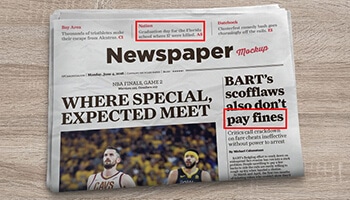
Analiza subiectului sau etichetarea subiectului este identificarea și extragerea sensului dintr-un text dat prin identificarea subiectelor/temelor recurente luate în considerare.
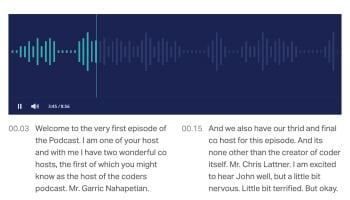
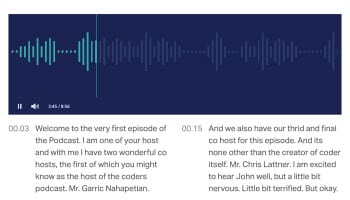
Transcrie discurs/podcast/seminar, apel conversație în text. Folosiți oamenii pentru a adnota cu acuratețe fișierele audio/vorbit pentru a antrena modelele NLP cu precizie.

Clasificați sunetele sau enunțurile pentru a clasifica vorbirea/audioul în funcție de limbă, dialect, semantică, lexicon etc.
Grupul nostru de experți care sunt competenți în adnotarea text/audio/etichetare poate procura seturi de date NLP precise și adnotate eficient.
Echipa noastră vă ajută să pregătiți date text/audio pentru antrenarea motoarelor AI, economisind timp și resurse prețioase.
Echipa noastră de colaboratori poate găzdui un volum suplimentar, menținând în același timp calitatea datelor de ieșire pentru soluțiile dvs. NLP.
În calitate de experți în formarea și managementul echipelor, ne asigurăm că proiectele sunt livrate în limitele bugetului definit.
Echipa analizează date din mai multe surse și este capabilă să producă date de instruire AI eficient și în volume în toate industriile.
Gama largă de date audio/text oferă AI cantități mari de informații necesare pentru a se antrena mai rapid.

Echipe dedicate și pregătite:

Cea mai mare eficiență a procesului este asigurată cu:

Platforma patentata ofera beneficii:
Chatbot-urile AI oferă utilizatorilor o experiență îmbunătățită prin învățarea din interacțiunile anterioare, înțelegerea comportamentului utilizatorului și înțelegerea diferitelor limbi folosind abilități avansate de luare a deciziilor.

Recunoașterea automată a vorbirii (ASR) a parcurs un drum lung. Deși a fost inventat cu mult timp în urmă, nu a fost folosit aproape niciodată de nimeni. Cu toate acestea, timpul și tehnologia s-au schimbat acum semnificativ.

Piața globală de procesare a limbajului natural este programată să crească de la 1.8 miliarde de dolari în 2021 la 4.3 miliarde de dolari în 2026, crescând la un CAGR de 19.0% în timpul perioadei.
Împuternicirea echipelor să construiască produse AI de top la nivel mondial.


NLP este o ramură a inteligenței artificiale care permite mașinilor să înțeleagă, să analizeze și să răspundă la limbajul uman, atât text, cât și vorbire, prin interpretarea contextului, sentimentelor și intenției.
NLP implică procesarea limbajului uman folosind algoritmi care analizează gramatica, sintaxa, semantica și contextul. Se bazează pe volume mari de date adnotate pentru a antrena modele de inteligență artificială să extragă semnificații, să identifice tipare și să genereze răspunsuri precise.
NLP este utilizat în aplicații precum asistenți virtuali, chatbots, analiza sentimentelor, traducerea automată, sumarizarea textului, detectarea spamului și corectarea gramaticală. Acesta alimentează sistemele care fac interacțiunile om-computer mai eficiente și mai naturale.
Serviciile NLP includ colectarea de text (obținerea de date textuale diverse), colectarea audio (înregistrarea datelor vocale), adnotarea datelor (etichetarea textului și a audio-ului pentru antrenarea inteligenței artificiale) și transcrierea (conversia vorbirii în text pentru analiză).
Soluțiile NLP îmbunătățesc modelele de inteligență artificială prin furnizarea de seturi de date etichetate cu precizie, care ajută modelele să înțeleagă mai bine limbajul uman. Acest lucru îmbunătățește sarcini precum analiza sentimentelor, recunoașterea entităților numite (NER), inteligența artificială conversațională și instruirea chatbot-urilor.
Industriile cheie includ asistența medicală (analiza dosarelor medicale și a sentimentelor pacienților), finanțele (detectarea fraudelor și analiza documentelor) și comerțul electronic (recomandări personalizate și automatizarea asistenței pentru clienți).
Cronologiile variază în funcție de dimensiunea și complexitatea proiectului, dar sunt optimizate pentru a furniza date de înaltă calitate în mod eficient.
Calitatea este garantată prin procese riguroase de validare, adnotatori experți și instrumente avansate, asigurând că datele îndeplinesc cele mai înalte standarde.
Costurile depind de factori precum amploarea proiectului, complexitatea datelor și nevoile de personalizare. Contactați Shaip pentru o ofertă personalizată în funcție de cerințele dumneavoastră.
NLP ca serviciu se referă la un model de livrare a datelor complet gestionat, în care un furnizor de servicii NLP gestionează fiecare etapă a fluxului dvs. de date lingvistice - colectare, adnotare, asigurarea calității și livrare - în numele dvs. Shaip oferă modele de livrare bazate pe proiecte, abonament și echipe integrate, pentru a se potrivi diferitelor nevoi organizaționale și dimensiuni ale proiectelor.
Fiecare grup lingvistic este alcătuit din vorbitori nativi sau aproape nativi, recrutați și evaluați pentru cunoștințele domeniului. Adnotările sunt calibrate în funcție de seturi de referință standard, iar un proces de calitate 6 Sigma stage-gate cu scorare a acordului inter-anotatori asigură consecvența în toate perechile de limbi și dialectele.
Shaip operează fluxuri de lucru compatibile cu HIPAA pentru proiectele NLP din domeniul sănătății și se aliniază cu cerințele de gestionare a consimțământului GDPR pentru colectarea datelor din UE. Toate proiectele includ documentație de audit trail, înregistrări de proveniență a datelor și controale de acces bazate pe roluri pentru echipele de conformitate ale întreprinderilor.
Da. Shaip oferă seturi de date care urmăresc instrucțiunile, perechi de răspunsuri prompte și date de preferință RLHF pentru reglarea fină și alinierea LLM. Pagina noastră de soluții de inteligență artificială generativă acoperă întreaga gamă de servicii de date pentru instruirea LLM.
Colectarea datelor implică obținerea de text sau audio brut - materialul de intrare din care modelul va învăța. Adnotarea implică etichetarea acelor date brute cu etichete structurate, categorii, entități sau indicatori de sentiment care îi spun modelului ce să înțeleagă. Shaip oferă atât ca servicii independente, cât și ca o soluție integrată de date NLP end-to-end.
Da. Shaip a lucrat cu startup-uri aflate în stadiu incipient, IMM-uri și companii din topul Fortune 500. Oferim o definire flexibilă a domeniului de aplicare al proiectului, pachete de seturi de date minime viabile pentru inteligența artificială în stadiul MVP și modele de livrare scalabile care cresc odată cu cerințele dumneavoastră de adnotare. Contactați-ne pentru o ofertă personalizată.

Folosim cookie-uri pentru a vă îmbunătăți experiența pe site-ul nostru. Folosind site-ul nostru, sunteți de acord cu cookie-urile.
Gestionați-vă preferințele cookie mai jos:
Cookie-urile esențiale permit funcțiile de bază și sunt necesare pentru buna funcționare a site-ului.
Google Tag Manager simplifică gestionarea etichetelor de marketing pe site-ul dvs. web fără modificări de cod.
Cookie-urile de statistică colectează informații în mod anonim. Aceste informații ne ajută să înțelegem cum folosesc vizitatorii site-ul nostru.
Google Analytics este un instrument puternic care urmărește și analizează traficul site-ului web pentru a lua decizii de marketing informate.
URL serviciu: policies.google.com (se deschide într-o fereastră nouă)
Cookie-urile de marketing sunt folosite pentru a urmări vizitatorii site-urilor web. Intenția este de a afișa reclame relevante și captivante pentru utilizatorul individual.
Google Ads este o platformă de publicitate online care permite companiilor să creeze reclame direcționate afișate în rezultatele căutării Google și pe site-urile partenerilor.
URL serviciu: policies.google.com (se deschide într-o fereastră nouă)
HubSpot este o platformă multifuncțională de marketing, vânzări și servicii pentru clienți, care simplifică creșterea afacerii.
URL serviciu: legal.hubspot.com (se deschide într-o fereastră nouă)
Puteți găsi mai multe informații în Politica noastră privind cookie-urile și Politica de confidențialitate.